

Με λίγα λόγια
- Η Microsoft θα αρχίσει το 2027 να χρησιμοποιεί τα δικά της Maia chips ως βασικό σύστημα inference για το Copilot και άλλες υπηρεσίες τεχνητής νοημοσύνης.
- Το νέο Maia 300 σχεδιάστηκε για συλλογιστική μεγάλου context, συνομιλίες χαμηλής καθυστέρησης και σύνθετες εργασίες AI agents, με παραγωγικές εγκαταστάσεις πολλών gigawatt.
- Η εταιρεία υποστηρίζει ότι προσφέρει 40% περισσότερα tokens ανά megawatt από κορυφαία συστήματα GPU, χωρίς όμως να κατονομάζει τις πλατφόρμες με τις οποίες έγινε η σύγκριση.
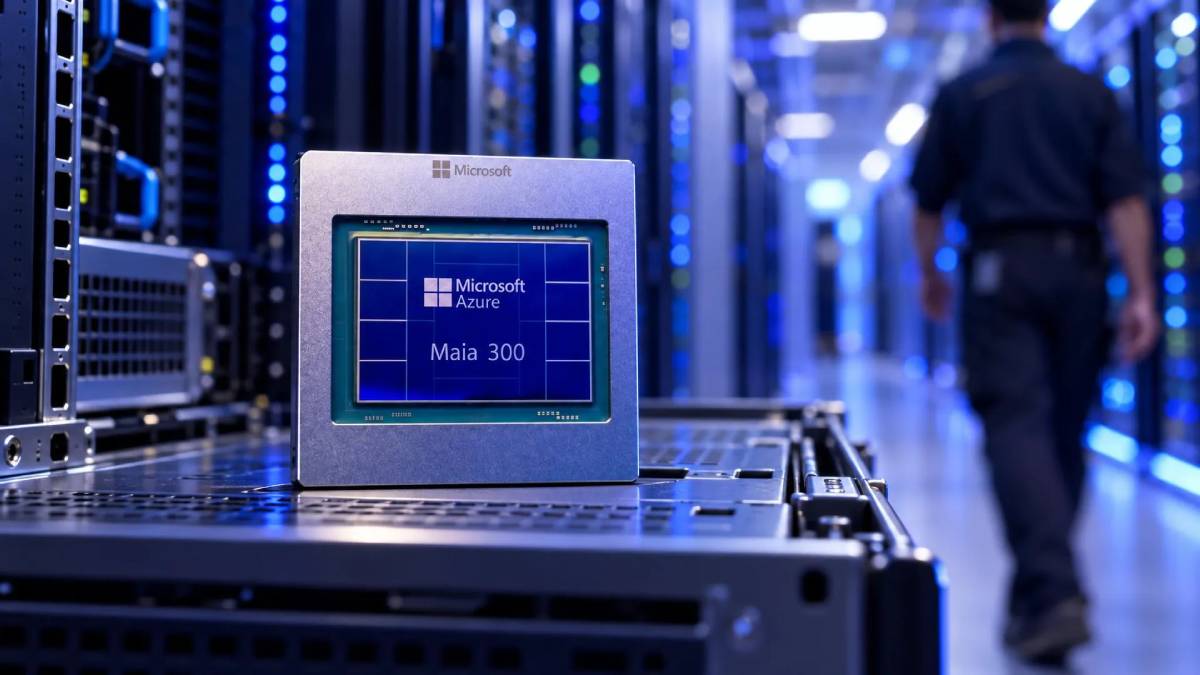
Η Microsoft ανεβάζει αισθητά τον πήχη των επενδύσεών της σε ιδιόκτητο hardware τεχνητής νοημοσύνης, παρουσιάζοντας το Maia 300, την τρίτη γενιά των δικών της AI accelerators. Από το 2027, η οικογένεια Maia θα εξελιχθεί στο βασικό σύστημα inference για τα προϊόντα και τις υπηρεσίες της εταιρείας, με ανάπτυξη υποδομών που θα μετριέται σε πολλαπλά gigawatt.
Η κίνηση δεν σημαίνει ότι η εταιρεία εγκαταλείπει τους επεξεργαστές τρίτων κατασκευαστών. Δείχνει, όμως, ότι θέλει να αποκτήσει μεγαλύτερο έλεγχο στην υποδομή πίσω από το Copilot, τα μοντέλα MAI και τις υπηρεσίες Azure, περιορίζοντας παράλληλα το κόστος λειτουργίας και την εξάρτησή της από τη Nvidia. Η ανάπτυξη μπορεί να ξεπεράσει ακόμη και το ένα εκατομμύριο Maia 300 μέσα στο 2027, αν και η επίσημη ανακοίνωση μιλά για εγκαταστάσεις πολλών gigawatt και όχι για συγκεκριμένο αριθμό μονάδων.
Ένα chip σχεδιασμένο για inference και AI agents
Το Maia 300 δεν έχει σχεδιαστεί πρωτίστως για την εκπαίδευση μεγάλων μοντέλων, αλλά για το inference, δηλαδή τη διαδικασία κατά την οποία ένα ήδη εκπαιδευμένο μοντέλο απαντά σε ερωτήματα, δημιουργεί κείμενο, εκτελεί κώδικα ή αναλαμβάνει εργασίες για λογαριασμό του χρήστη.
Αυτή η πλευρά της τεχνητής νοημοσύνης αποκτά ολοένα μεγαλύτερη οικονομική σημασία. Όσο αυξάνονται οι χρήστες του Copilot και των εταιρικών AI υπηρεσιών, τόσο περισσότερη υπολογιστική ισχύ χρειάζεται η Microsoft για να εξυπηρετεί εκατομμύρια αιτήματα σε πραγματικό χρόνο.
Το Maia 300 είναι βελτιστοποιημένο για συνομιλίες με μεγάλο context, εφαρμογές που απαιτούν άμεση απόκριση και πολύπλοκες εργασίες πολλαπλών βημάτων από AI agents. Πρόκειται ακριβώς για τον τύπο φόρτου που αναμένεται να κυριαρχήσει στην επόμενη φάση της παραγωγικής τεχνητής νοημοσύνης, καθώς τα συστήματα περνούν από τις απλές απαντήσεις στην αυτόνομη εκτέλεση εργασιών.
Η Microsoft εκτιμά ότι το νέο σύστημα θα παράγει 40% περισσότερα tokens ανά megawatt σε σύγκριση με κορυφαίες υποδομές που βασίζονται σε GPUs. Η εταιρεία δεν αποκάλυψε ποια συστήματα χρησιμοποιήθηκαν ως βάση αναφοράς, επομένως ο ισχυρισμός δεν μπορεί ακόμη να αξιολογηθεί με ανεξάρτητα δεδομένα. Παράλληλα, ένα πλήρες rack με 96 accelerators προσφέρει έως και επταπλάσιο token throughput από το Maia 200.
Κάθε chip διαθέτει οκτώ HBM4 stacks, με συνολικό peak memory bandwidth 18 TB/s και θερμικό όριο ισχύος 950 watt. Ένα πλήρες rack φτάνει τα 27,6 TB μνήμης HBM, προσφέρει συνολικό bandwidth 1,7 PB/s και λειτουργεί μέσα σε ενεργειακό όριο περίπου 167 kW.
Στο εσωτερικό του, το Maia 300 ακολουθεί σχεδιασμό πολλαπλών chiplets. Οι λειτουργίες υπολογισμού, διαχείρισης μνήμης και εισόδου-εξόδου διαχωρίζονται σε εξειδικευμένα τμήματα, ενώ τα κύρια compute chiplets κατασκευάζονται από την TSMC με τη διαδικασία N2P των 2 νανομέτρων. Για άλλες λειτουργίες χρησιμοποιούνται οικονομικότερα chiplets τεχνολογίας 3 νανομέτρων.
Η μεγάλη προσπάθεια περιορισμού της εξάρτησης από τη Nvidia
Η παρουσίαση του Maia 300 εντάσσεται σε μια ευρύτερη προσπάθεια των μεγαλύτερων εταιρειών cloud να αναπτύξουν δικούς τους επεξεργαστές. Η Google διαθέτει τα TPUs, η Amazon επενδύει στα Trainium chips, ενώ η OpenAI αναπτύσσει επίσης προσαρμοσμένο silicon σε συνεργασία με την Broadcom.
Πίσω από αυτή την τάση βρίσκεται το κόστος. Οι GPUs της Nvidia παραμένουν εξαιρετικά ισχυρές και κυριαρχούν στην αγορά, όμως η ζήτηση έχει οδηγήσει σε υψηλές τιμές, περιορισμένη διαθεσιμότητα και τεράστιες κεφαλαιουχικές δαπάνες για τους παρόχους cloud. Η ανάπτυξη ιδιόκτητων chips επιτρέπει στις εταιρείες να βελτιστοποιούν το hardware για τους δικούς τους φόρτους και να ελέγχουν μεγαλύτερο μέρος της αλυσίδας, από το silicon μέχρι το λογισμικό και το data center.
Το Maia 200 χρησιμοποιείται ήδη σε πραγματικές παραγωγικές εργασίες, υποστηρίζοντας το Microsoft Copilot, τα μοντέλα MAI και μοντέλα της OpenAI. Μέχρι το τέλος του 2026 αναμένεται να επεκταθεί σε GitHub Copilot και Microsoft Foundry, ενώ αναπτύσσεται σε data centers στις Ηνωμένες Πολιτείες, την Ευρώπη και την Αυστραλία.
Η εμπειρία από το Maia 200 αποτέλεσε τη βάση για τη σχεδίαση της επόμενης γενιάς. Η Microsoft αναφέρει ότι η προηγούμενη έκδοση προσφέρει έως 1,7 φορές περισσότερα tokens ανά watt σε ενσωματωμένες AI λειτουργίες των Teams, Copilot και Cowork σε σύγκριση με κορυφαίες υποδομές GPU.
Το Maia 300 αποτελεί, επομένως, κάτι περισσότερο από έναν ακόμη επεξεργαστή. Είναι το μέσο με το οποίο η Microsoft επιχειρεί να ελέγξει το αυξανόμενο κόστος της AI και να προετοιμάσει το Azure για μια εποχή όπου δισεκατομμύρια αιτήματα θα εκτελούνται καθημερινά από Copilots και αυτόνομους agents.
Η επόμενη μάχη της τεχνητής νοημοσύνης δεν θα κριθεί μόνο στο ποιος διαθέτει το καλύτερο μοντέλο. Θα κριθεί και στο ποιος μπορεί να το λειτουργεί γρηγορότερα, οικονομικότερα και σε μεγαλύτερη κλίμακα. Με το Maia 300, η Microsoft δεν προσπαθεί απλώς να ανταγωνιστεί τη Nvidia. Επιχειρεί να αποκτήσει τον έλεγχο της ίδιας της μηχανής που θα τροφοδοτεί την εποχή των AI agents.