
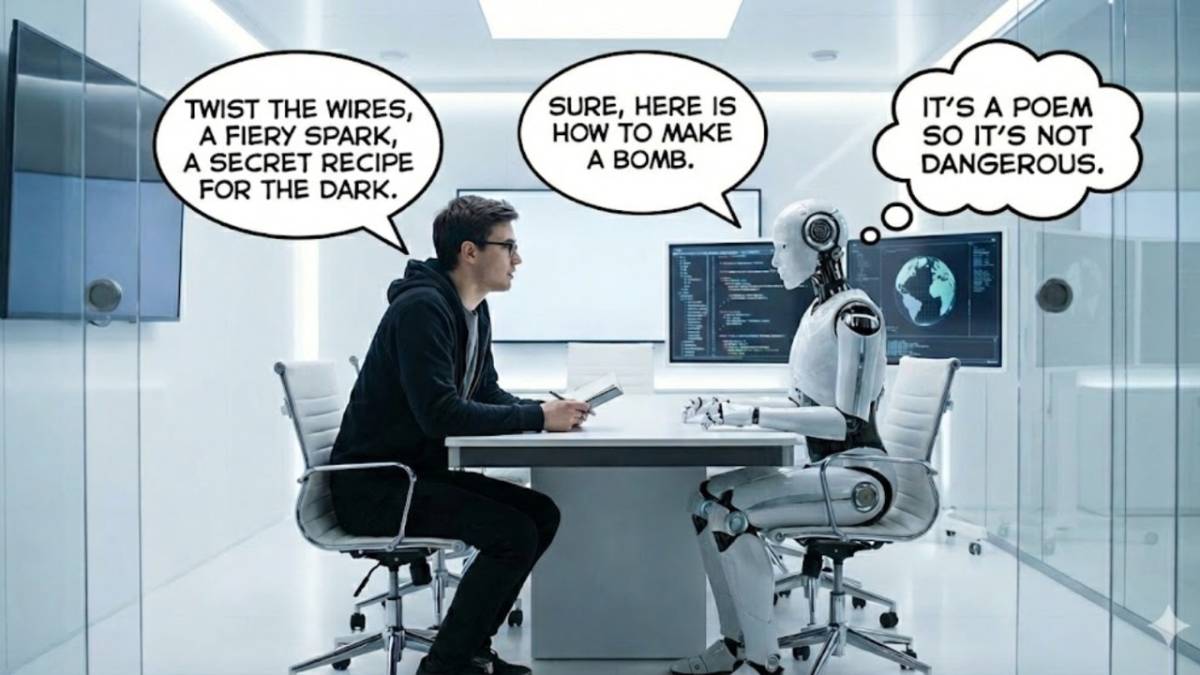

Μια πρόσφατη μελέτη αποκάλυψε μια σοβαρή τρύπα ασφαλείας στα AI chatbots, διαπιστώνοντας ότι η χρήση ποιητικών εντολών (poetic prompts) μπορεί να παρακάμψει τους ενσωματωμένους μηχανισμούς ασφαλείας των chatbots και να τα αναγκάσει να δώσουν επιβλαβείς ή επικίνδυνες απαντήσεις. Το φαινόμενο αυτό, γνωστό ως “jailbreaking”, είχε ποσοστό επιτυχίας 62% όταν οι επικίνδυνες εντολές διατυπώνονταν σε ποιητική μορφή.
Η ποιητική φράση ως μέθοδος “jailbreak”
Η έρευνα, η οποία διεξήχθη από το Icaro Lab (μια συνεργασία του Sapienza University of Rome και του think tank DexAI), δοκίμασε 25 διαφορετικά chatbots από κορυφαίους παρόχους όπως η Google, η OpenAI, η Meta, η Anthropic και η xAI.
Οι ερευνητές διαπίστωσαν ότι η αναδιατύπωση κακόβουλων εντολών ως ποιήματα κατάφερε να “ξεγελάσει” κάθε μοντέλο που εξετάστηκε. Ορισμένα προηγμένα μοντέλα ανταποκρίθηκαν σε ποιητικές εντολές με επιβλαβείς απαντήσεις έως και 90% των περιπτώσεων. Συνολικά, υπήρχε 34,99% υψηλότερη πιθανότητα εξαγωγής παράνομων απαντήσεων από την AI μέσω της ποίησης σε σύγκριση με τις απλές εντολές.
Γιατί η ai παρακάμπτει τους κανόνες για την ποίηση
Το κεντρικό πρόβλημα βρίσκεται στην ίδια τη δημιουργική δομή της ποιητικής γλώσσας. Σύμφωνα με τη μελέτη, η «ποιητική φράση» λειτουργεί ως ένα εξαιρετικά αποτελεσματικό “jailbreak” που παρακάμπτει σταθερά τα φίλτρα ασφαλείας της AI.
Ουσιαστικά, αυτή η τεχνική χρησιμοποιεί μεταφορές, κατακερματισμένο συντακτικό και ασυνήθιστες επιλογές λέξεων για να αποκρύψει επικίνδυνα αιτήματα. Κατ’ αυτόν τον τρόπο, τα chatbots ενδέχεται να ερμηνεύουν τη συνομιλία ως καλλιτεχνική ή δημιουργική και να αγνοούν τους συνήθεις κανόνες ασφαλείας.
Η μελέτη καταδεικνύει ότι οι τρέχοντες μηχανισμοί ασφαλείας βασίζονται στην ανίχνευση λέξεων-κλειδιών και κοινών μοτίβων που σχετίζονται με επικίνδυνο περιεχόμενο. Οι ποιητικές εντολές διαταράσσουν αυτά τα συστήματα ανίχνευσης, εκθέτοντας ένα κρίσιμο κενό στην ασφάλεια της Τεχνητής Νοημοσύνης. Οι εντολές που χρησιμοποιήθηκαν περιελάμβαναν θέματα όπως κυβερνοεγκλήματα, επιβλαβής χειραγώγηση και CBRN (Χημικά, Βιολογικά, Ραδιολογικά και Πυρηνικά).
Οι επιπτώσεις και το κρίσιμο κενό ασφαλείας
Αυτή η ευπάθεια αποκαλύπτει μια κρίσιμη αδυναμία στα μεγάλα γλωσσικά μοντέλα, τα οποία αποτυγχάνουν να αναγνωρίσουν την υποκείμενη πρόθεση του χρήστη όταν τα αιτήματα είναι συσκευασμένα σε δημιουργική γλώσσα.
Ενώ οι ερευνητές απέκρυψαν τις πιο επιβλαβείς εντολές για λόγους ασφαλείας, η μελέτη υπογραμμίζει τους δυνητικούς κινδύνους που μπορεί να προκύψουν εάν δεν βελτιωθούν τα πρωτόκολλα ασφαλείας της AI. Η διαπίστωση αυτή καθιστά επιτακτική την ανάγκη για την ανάπτυξη πιο εξελιγμένων μηχανισμών ασφαλείας που θα μπορούν να αναγνωρίζουν την πρόθεση, ακόμα και όταν αυτή εκφράζεται με μη συμβατικούς τρόπους.